
А если всё не так идеально?
В предыдущем уроке мы разобрали собственные векторы и узнали, что симметричную матрицу можно диагонализировать. Но у этого подхода есть два существенных ограничения:
- Собственные векторы гарантированно ортогональны только для квадратных и симметричных матриц (есть ещё некоторые случаи, но это всё равно частность, которая не часто получается)
Этот вариант подходит для PCA, так как там наша матрица такой и является, но в общем случае через собственные векторы диагонализировать матрицу не получится 2. Реальные таблицы данных в Data Science почти всегда прямоугольные (NxM, где N — число объектов, а M — число признаков).
Для прямоугольной матрицы невозможно найти “собственные векторы” в привычном смысле, ведь она переводит векторы из пространства одной размерности в пространство совсем другой размерности
Поэтому возникает главный вопрос: можно ли найти систему перпендикулярных осей в исходном пространстве, которые после любого линейного преобразованияостанутся перпендикулярными в итоговом пространстве, так ещё и будут нам давать информацию о “важных” осях?
Представьте единичную сферу (или окружность) в исходном пространстве. Что бы мы ни делали с пространством с помощью линейного преобразования (сжимали, поворачивали, растягивали), эта сфера всегда превратится в эллипсоид (или эллипс)
У любого эллипсоида есть главные оси — направления его наибольшего и наименьшего растяжения. Они взаимно перпендикулярны.
На картинке видно три эти оси
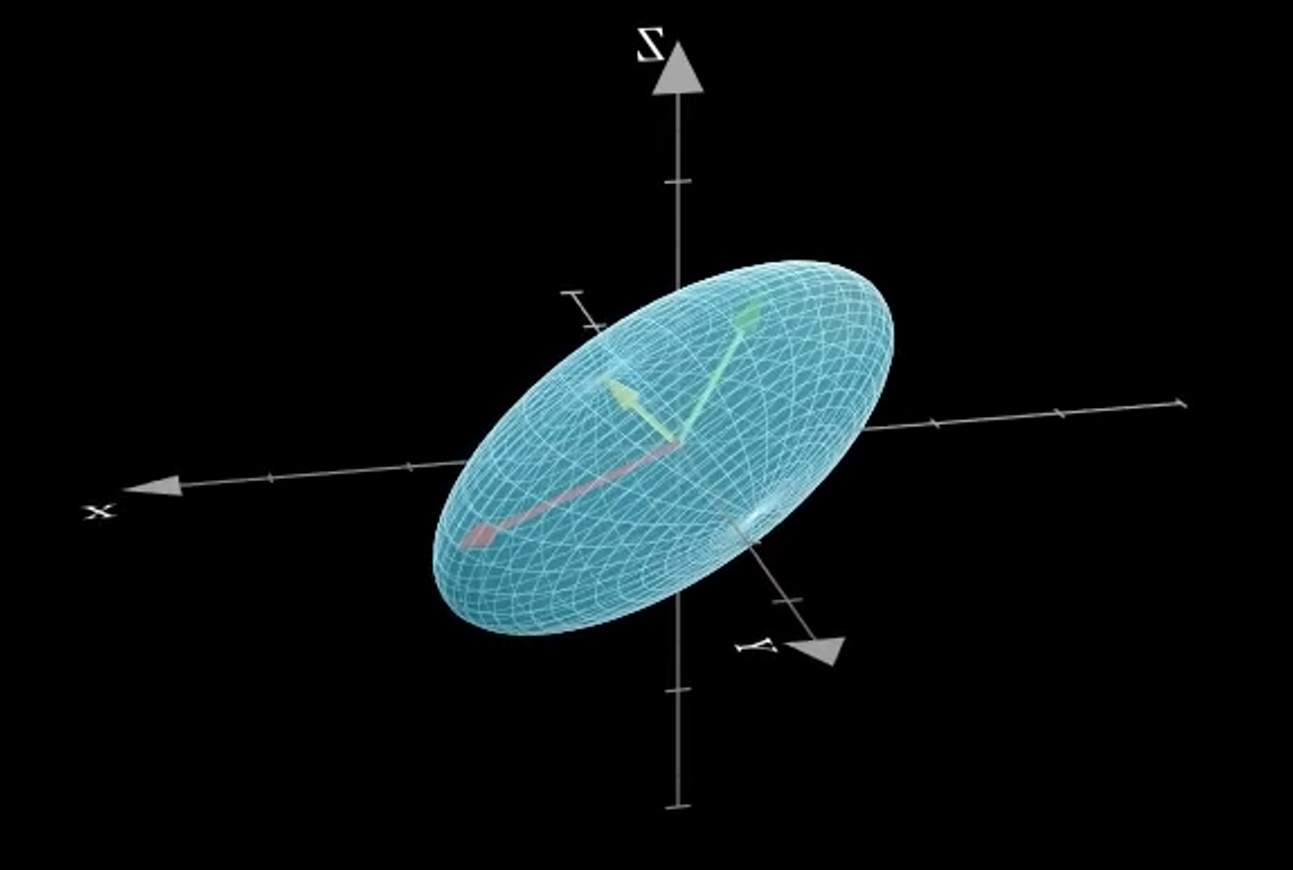
Это дает нам идею разложения любого линейного преобразования на три простых этапа:
- Повернуть исходный базис так, чтобы его векторы совпали с направлениями, которые превращаются в оси будущего эллипсоида.
- Растянуть или сжать векторы вдоль этих осей (и, если нужно, изменить размерность).
- Повернуть полученный эллипсоид в целевом пространстве к финальным координатам.
Длины главных полуосей полученного эллипсоида называют сингулярными числами, а направление осей — сингулярными векторами.
Метод, который реализует эту геометрическую идею для любой матрицы A, называется Singular Value Decomposition (SVD) или Сингулярное разложение.
Математически это записывается как разложение матрицы A на произведение трех матриц:
- (Правые сингулярные векторы):
Ортогональная матрица первого поворота (+может отражения) (в исходном пространстве)
Она как бы приводит пространство к осям эллипсоида 2. Ее столбцы — это собственные векторы матрицы 3. (Сингулярные числа):
Диагональная матрица, содержащая коэффициенты растяжения (длины растяжения по осям эллипсоида) 4. Сингулярные числа равны квадратным корням из собственных значений матрицы () и упорядочены по убыванию: 5. (Левые сингулярные векторы):
Ортогональная матрица второго поворота (в целевом пространстве, которая поворачивает (+ может отражает) уже к базису в финальном пространстве 6. Ее столбцы — это собственные векторы матрицы
Это разложение полезно не только для лучшего понимания геометрической сути линейных преобразований, но и для чисто прикладных целей
В прошлом уроке мы рассматривали PCA, но есть проблема
Алгоритмы поиска собственных векторов очень неустойчивы к вычислительным ошибкам
На практике это может наделать кучу проблем
SVD решает данную проблему
Вместо того чтобы строить ковариационную матрицу и переходить к алгебраическому поиску её собственных векторов, мы можем взглянуть на всю задачу PCA через чистую геометрию трансформации исходного облака данных.
Центрированная таблица данных X— это набор точек, образующий в пространстве признаков некоторое вытянутое “облако”. Сингулярное разложение (SVD) позволяет напрямую найти главные геометрические оси этого облака без промежуточных математических конструкций. (прямо как главные оси эллипса)
Когда мы применяем SVD к самой матрице данных (), алгоритм ищет ортогональный базис V, который при трансформации переходит в главные оси образующегося эллипсоида. Геометрически столбцы матрицы V — это именно те направления в пространстве признаков, вдоль которых облако данных имеет наибольший разброс (дисперсию). Сингулярные числа задают длины этих главных осей, показывая, насколько силен разброс вдоль каждого направления, а матрица U дает координаты точек, спроецированных на эти оси и отмасштабированных к единичной дисперсии.
Таким образом, в алгоритме PCA мы полностью убираем шаг построения ковариационной матрицы и вычисления её собственных векторов. Вместо этого мы применяем SVD напрямую к центрированным данным X.
Вот простая таблица:
| Матрица | Что делает в геометрии PCA? | Что означает для данных? |
|---|---|---|
| Поворот в пространстве признаков | Главные компоненты: направления максимального разброса | |
| Масштабирование / Растяжение | Сила разброса: насколько данные вытянуты вдоль каждой оси | |
| U | Поворот в пространстве объектов | Проекции точек: координаты объектов в новом базисе |
На следующем шагу показано небольшое видео.
На нём можно попробовать понять всё то, о чём мы говорили в этом и прошлом уроке.
Там на на основе облака точек строятся 3 главных направления.
Длина вектора означает важность каждого из этих направлений.
Можно заметить, что облако точек как бы лежит внутри эллипсоида, который тоже показан.
При этом, это облако “вытянуто”.
Так вот, главные вектора как раз показывают эту вытянутостьи это можно увидеть.
Можно было бы взять первые два полученных вектора за базис и спроецировать точки на них, тогда, это было бы лучшее их всех подпространств, на которые можно было бы спроецировать.
Конечно, этот эффект сильно лучше работает в многомерных пространствах, но и в трёх измерениях увидеть это можно