
Борьба с избыточностью 2
В прошлом уроке мы пришли к выводу, что большие размерности это проблема и с ней надо как-то бороться
Сначала более бытовой пример
Попробуйте представить проекцию целого рисунка на бумаге на прямую
Много ли информации о рисунке сохранится?
Думаю достаточно понятно, что нет
В большинстве случаев понять, что изображено будет примерно невозможно
А если спроецировать что-то трёхмерное на двумерную плоскость?
Это, по факту, получится фотография
Да, фотография далеко не всю информацию сохраняет, но всё равно, понять изначальную картину в общих чертах возможно
Может показаться, что это потому что в первом случае мы поделили размерность на два (2 -> 1), а во втором случае разделили на 1.5 (3 -> 2)
Но на самом деле, дело не только в этом
Всё зависит от того, как устроены реальные данные. Формально 100-мерное пространство способно хранить гигантский объём информации. Однако на практике переменные часто коррелируют и дублируют друг друга. В итоге уникальнойи полезнойинформации в данных оказывается существенно меньше, чем максимальная вместимость пространства.
Именно поэтому мы почти всегда можем подобрать такое удачное подпространство, чтобы спроецировать 100-мерные данные, например, на 20-мерные — и при этом сохранить практически всю ключевую структуру (то есть реальные потери будут не в 5 раз, а незначительными)
Об этом говорит так называемая Лемма Джонсона — Линденштраусса
Она утверждает, что если нам важно сохранить расстояния между точками с погрешностью не более, чем и у нас всего N точек в данных, то необходимая размерность, на которую можно спроецировать данные примерно равна:
(C - какая-то константа, но нам это не так важно)
Важно, что логарифм растёт очень медленно, а значит чем больше размерность, тем на относительно меньшее пространство его можно спроецировать
Но как найти нужное подпространство, на которое спроецировать?
А, на самом деле, мы это уже умеем
Это алгоритм PCAв связке с SVD
В диагональной матрице алгоритма SVD у нас стоят сингулярные числа в порядке убывания
Чем больше число, чем больше информации хранит данное направление
Остаётся взять первый k чисел и составить соответствующее им подпространство (подробнее про это был урок “А если не всё не так идеально”)
На практике обычно просто смотрят на сингулярные числа и выбирают несколько наибольших
Если с какого-то момента они становятся относительно маленькими, значит информации в соответствующих направлениях практически нет
Мы рассмотрели только линейные преобразования, но есть иногда и более эффективные способы снизить размерность данных
Например, на фото представлено распределение точек
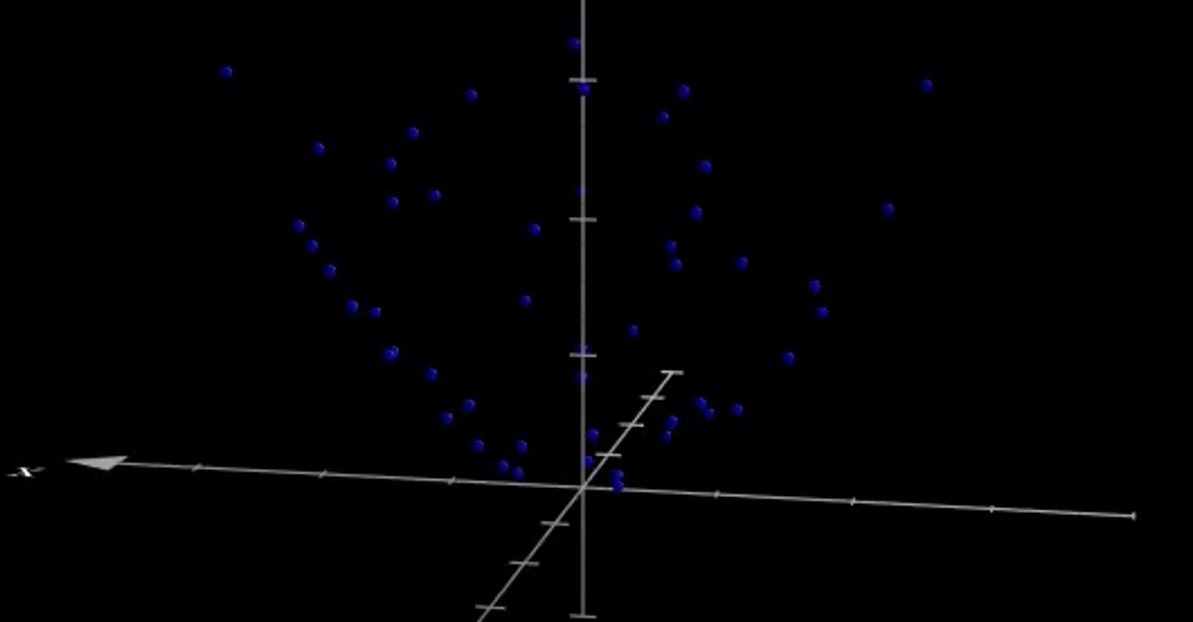
Видно, что точки одновременно и достаточно случайно расположены, но как будто какая-то закономерность есть
В данном случае, все точки находятся на поверхности (многобразии) “эллиптический параболоид”
На фото это можно увидеть
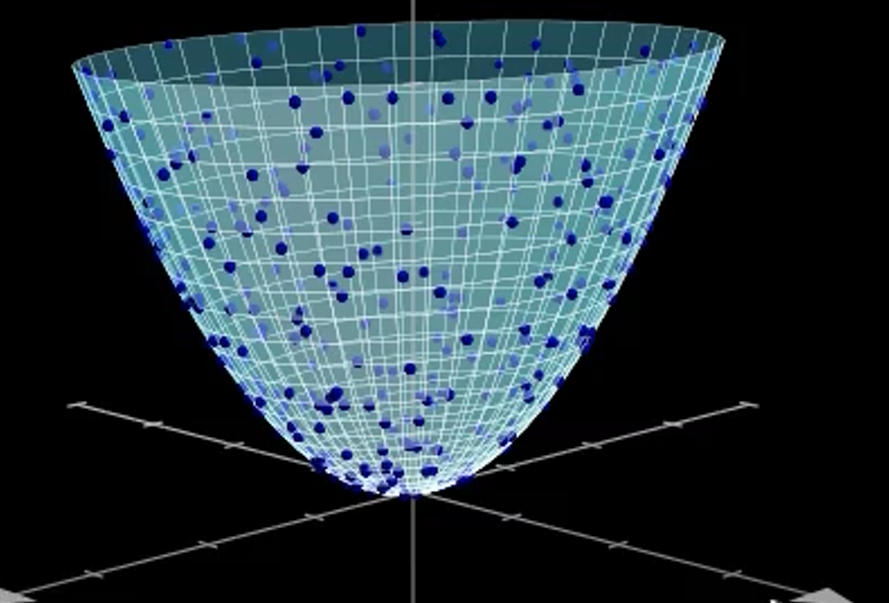
Эту поверхность можно параметризовать двумя параметрами, то есть, задать систему координат прямо на ней, чтобы все точки можно было выразить через две координаты
Точки, которые не ровно на него упали можно на него спроецировать (просто найдя ближайшую к изначальной точке точку на поверхности)
Получается, мы смогли ужать 3 размерности до двух практически вообще ничего не потеряв
Похожим методом мы пользовались в полиномиальной регрессии
Только там мы заменяли прямую на кривую, а здесь подпространства на “кривые” подпространства (поверхности)
Такой идеей занимается геометрический анализ данных
Идея состоит в том, что данные в больших размерностях практически всегда лежат на какой-то сложной многомерной поверхности
И это решает сразу две проблемы:
-
Помогает точнее описывать данные, уменьшая количество параметров
-
Говорит о геометрии самих данных, что не менее важно
Самая сложная задача: понять на какой поверхности примерно лежат данные
Видов поверхностей примерно бесконечно много, особенно в больших размерностях и это уже очень сложная тема, которая сейчас активно развивается
Разберём чуть подробнее
Поверхность(или многообразие) это то, что локально очень похоже на обычное пространство (например, на двумерное пространство, то есть, на плоскость), но глобально может быть сильно искривлено.
Как пример - сфера.
Если очень сильно приблизиться к какой-нибудь точке, то мы особо не отличим сферу от плоскости.
Точно так же, как когда-то люди думали, что земля плоская.
Если многообразие локально как n-мерное пространство, то оно параметризуется n числами.
То есть, можно задать систему из n координат.
Правда, гарантированно это работает только рядом с какой-то точкой, глобальная параметризация далеко не всегда возможна.
Например, ту же сферу (какой бы простой она не казалась) нельзя достаточно хорошо параметризовать глобально.
Ещё примеры:
-
Любой полиномлокально похож на прямую (например, парабола) и это как раз многообразия размерности 1
-
Если у кого была аналитическая геометрия в вузе, может помнят кривые и поверхности второго порядка, это как раз многообразия размерности 1 и 2 соответственно
-
Тор(бублик) - тоже двумерное многообразие
Данные могут принимать форму любых из этих многообразий (и их аналогов в многомерных пространствах).
Когда мы проецируем такие изогнутые данные на плоскость через PCA, мы поступаем грубо: мы буквально разрезаем и расплющиваем искривлённый лист. Из-за этого:
- Мы теряем огромное количество информации (точки, далёкие на поверхности, могут наложиться друг на друга на плоскости);
- Мы ослабляем внутреннюю структуру;
- Мы можем потерять важные зависимости между признаками, которые были “зашиты” в изгибе этого листа.
Именно поэтому нам нужны алгоритмы, которые умеют разворачивать эти искривлённые поверхности, а не просто проецировать их на прямые оси координат.
Эта проблема похожа на перенос карты земли на плоскость.
Если просто взять и спроецировать на плоскость все города и страны, то они наложатся друг на друга, так ещё и все расстояния поломаются.
А если понять, что это двумерное многообразие, то работать с этим становится проще.
У нас частный случай этой проблемы. Если карта земли должна сохранять многое (например, углы) или требуется, чтобы она выглядела адекватно
То наша главная цель - сохранение относительных расстояний.
Но что такое расстояние на многообразии?
Это далеко не тоже самое, что обычное расстояние.
Расстояние на многообразии это то, какой путь нужно пройти “по многообразию”, чтобы дойти от одной точки до другой
Например, расстояние от Москвы до Нью-Йорка это то, сколько нужно пролететь на самолёте, если бы мы летели “по прямой”, а не то, сколько физически между ними расстояние (мы же не можем сквозь землю летать).
Напомню, что наша главная задача: сохранение относительных расстояний на многообразии
Остаётся решить три главные проблемы:
- Как найти это странное расстояние?
- Как понять, какую размерность имеет многообразие и, в следствии, понять размерность пространства на которое мы будем переносить точки
- Как перенести точки с искривлённого многообразия на плоское пространство, чтобы эти расстояния максимально хорошо сохранить? То есть, как “выпрямить” многообразие?
Решение этих вопросов мы разберём в следующем уроке
Представьте, что ваши данные лежат на поверхности обычной сферы (глобус), вложенной в 4-мерное пространство.
Какое утверждение о них верно?